CloudflareはAIクローラーを「Search」「Agent」「Training」の3区分で設定する方式に移行し、2026年9月15日には、検索向けクロールを維持しながら学習利用の拒否を設定できる「Disallow AI Training」を追加しました。現在は「学習を拒否するならSEOを犠牲にする」という二択ではありません。本記事では、3区分の意味、Trainingの選択肢ごとの違い、AI検索への影響、サイト種別ごとの考え方を2026年10月時点の情報で整理します。
※本記事は、awoo Intelligence Inc.が公開した下記ブログ記事を日本語に翻訳・再構成し、原文公開後に発表されたCloudflareの仕様変更(2026年9月15日)と各社の公式情報を反映したものです。
原文:https://www.awoo.ai/zh-hant/blog/cloudflare-ai-crawler-control/
この記事の要点
- CloudflareはAIクローラーを用途別に「Search」「Agent」「Training」の3区分に分け、それぞれ独立して設定できるようにしました。
- 2026年9月15日に「Disallow AI Training」が追加されました。この設定は、条件を満たすGooglebotなどの混合用途クローラーに学習拒否を通知して検索向けクロールを維持しつつ、学習専用クローラーへのアクセスを遮断します。
- Trainingで「Block」を選ぶと、Googlebot・Bingbot・Applebotなどの混合用途クローラー(検索と学習の両方に使われるクローラー)もサイト全体で遮断され、検索向けクロールに影響します。「Block on pages with ads」を選んだ場合は、広告掲載ページで同じ影響が出ます。
- AI検索での露出に関係するクローラーや利用目的の制御方法は、サービスごとに異なります。Cloudflareの3区分とあわせて、各サービスの設定を個別に確認する必要があります。
- 設定は、サイトの収益モデルやコンテンツ利用方針を踏まえて判断します。マーケティング部門とIT部門が、現在の設定と目標を一緒に確認することが出発点です。
※本記事は、awoo Intelligence Inc.が公開した下記ブログ記事を日本語に翻訳・編集したものです。
原文:https://www.awoo.ai/zh-hant/blog/2026-google-ads-ai-trend/
コンテンツ
なぜCloudflareはAIクローラーの扱いを変えたのか?
Cloudflareが設定方式を見直した背景には、AIクローラーの大量アクセスがサーバー負荷と広告収益の両方を圧迫している状況があります。マーケターはブランド情報がGemini、ChatGPT、PerplexityなどのAI回答に登場することを望む一方、AIクローラーによる高頻度の巡回はサイトのインフラに負担をかけ、広告収益型サイトのビジネスモデルを揺るがしています。
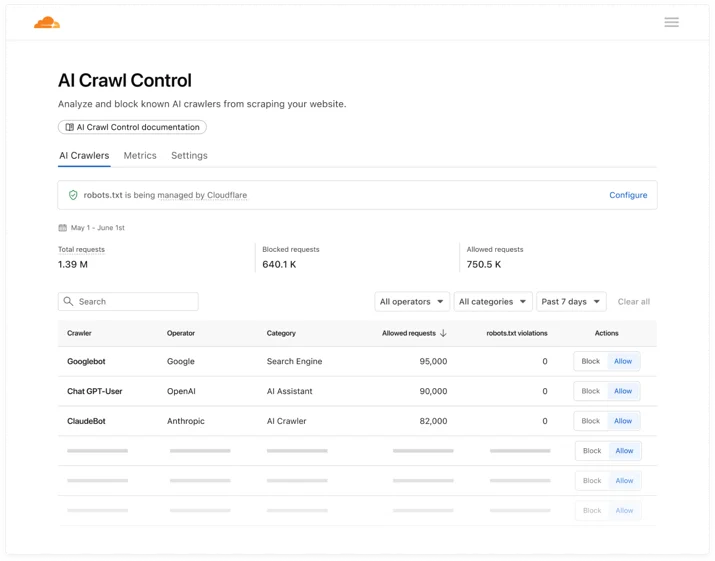
Cloudflareはこの課題に対し「Content Independence Day」と題した発表を行い、AIクローラーを管理する製品「AI Crawl Control」を提供しています。2026年9月15日には、従来の一括設定「Block AI Bots」を、Search・Training・Agentの3つの独立した設定に置き換え、用途別に判断しやすい形へ進化させました。あわせて「Managed Robots.txt」は「Bot Preference Sync」に置き換えられ、設定した意向がrobots.txtを通じて対応クローラーにまとめて通知されるようになっています。
Search・Agent・Trainingの3区分とは何か?
Cloudflareは、AIクローラーを目的に応じて3つの区分に分けています。
| 区分 | 目的 | 例 |
|---|---|---|
| Search | 検索インデックスを構築し、ユーザーの発見とクリックにつなげる | Googlebot、Bingbot |
| Agent | ユーザーの代わりにリアルタイムで情報を取得し、回答の要約やタスク実行を行う | ユーザーの依頼を受けてページを取得するAIアシスタント |
| Training | 大規模言語モデル(LLM)の学習用データをオフラインで収集する | Bytespider、CCBot |
個別のクローラーがどの区分に入るかは、Cloudflareの管理画面とCloudflare Radarで確認できます。
2026年9月15日に何が追加されたのか?
2026年9月15日の最大の変更は、学習拒否と検索掲載を両立させる「Disallow AI Training」の追加です。Cloudflareはこの設定を、検索結果に残ったままAI学習を拒否できる設定と説明しています。
この仕組みを支えるのが「Accountable」という新しい区分です。Cloudflareは、次の4条件を満たす、または満たすことを約束したクローラー運営者をAccountableとしています。
- robots.txtなどの標準的な方法で、AI学習のオプトアウトを提供する
- AIによる検索要約からのオプトアウトを提供する
- 検索と学習でコンテンツがどう使われたかを、URL単位で確認できるようにする
- 学習をオプトアウトしても、従来の検索順位に影響しないことを公表する
Apple、Google、MicrosoftはAccountableとされています。学習用と検索用のクローラーを分けている運営者(Amazon、Anthropic、Meta、OpenAI)の学習用クローラーもAccountableに分類されています。Cloudflareの2026年9月15日発表時点で、混合用途クローラーはCloudflareで検証済みのクローラー通信の36.6%を占めます。同発表時点で、検索クローラーをブロックしているサイトは1%未満である一方、AI学習を制限しているサイトは17%です。
Trainingの設定は、選択肢によって何が違うのか?
Trainingの設定で最も重要なのは、「Disallow AI Training」と、「Block」「Block on pages with ads」を区別することです。学習拒否を伝えたいのか、混合用途クローラーごと遮断したいのかで、検索向けクロールへの影響が変わります。
| Trainingの設定 | 内容 | 検索向けクロールへの影響 |
|---|---|---|
| Allow | 学習向けのクロールを許可する | なし |
| Disallow AI Training | Bot Preference Syncを通じてrobots.txtに学習拒否を公開し、Accountableな混合用途クローラーには学習拒否を通知する。Amazon・Anthropic・Meta・OpenAIなどの学習専用クローラーへのアクセスは遮断する | 原則なし(混合用途クローラーの検索向けクロールは維持) |
| Block | Googlebot、Bingbot、Applebotを含む混合用途クローラーも遮断する | 検索用クロールも遮断され、ページの発見・更新に影響する |
| Block on pages with ads | 広告を掲載していると判定されたページで、混合用途クローラーも遮断する | 広告掲載ページの発見・更新に影響する |
この表はTraining設定単独の影響を示しています。Search設定やWAFなど、ほかのアクセス制御によって遮断される場合があります。
この表を使う際は、次の2点にも注意してください。
- Bingへの自動通知は未対応です。 Disallow AI Trainingからrobots.txtを通じてBingへ学習拒否を自動通知する仕組みは、2026年10月時点で未対応です。Microsoftは2027年初めの対応を目標としています。それまでBingに対して学習拒否を伝えたい場合は、NOARCHIVEメタタグなどの方法を別途検討する必要があります。
- 「広告ページのみ」の設定にDisallow版はありません。 広告掲載ページの一覧は規模が大きく変化も激しいため、robots.txtでは表現できないとCloudflareは説明しています。広告ページに限定する場合は、混合用途クローラーも遮断する「Block on pages with ads」を選ぶことになります。
既存サイトの設定はどう移行されたのか?
既存サイトは、一律に新しい初期値へ切り替わったわけではなく、以前の設定に応じて移行されています。Cloudflareは、多くのユーザーは対応不要としています。
| 以前の状態 | 移行後の設定 |
|---|---|
| 細かい設定を使っておらず、「Block AI Bots」が無効 | 3区分ともAllow |
| 細かい設定を使っておらず、「Block AI Bots」がBlockまたは「広告ページでBlock」 | Search=Allow、Training=Disallow AI Training、Agent=Block on pages with ads |
| 細かい設定を使っており、TrainingがBlockまたはBlock on pages with ads | Training=Disallow AI Trainingに変換(SearchとAgentはそのまま) |
| 細かい設定を使っており、TrainingがAllow | そのまま |
検索向けクロールを含めて混合用途クローラーを遮断したいサイトは、移行後にBlockを明示的に選び直す必要があります。逆に、以前にBlockを選んでいたサイトは、現在の設定がDisallow AI Trainingに変わっていることを確認しておくべきです。
新規サイトの推奨初期値はどうなっているのか?
2026年9月15日以降に追加されたドメインには、広告の有無に応じた推奨設定が提示されます。
| 区分 | 広告収益型サイト | それ以外のサイト |
|---|---|---|
| Bot Preference Sync | 有効 | 有効 |
| Search | Allow | Allow |
| Training | Disallow AI Training | Allow |
| Agent | Block on pages with ads | Allow |
AI検索に表示されるかどうかは、どのクローラーが関係するのか?
AI検索での露出は、Cloudflareの「Agent」区分だけでは決まりません。AIサービスによって、用途別にクローラーを分ける場合と、同じクローラーで取得して利用目的を別途制御する場合があります。たとえばGoogle-Extendedは独立した取得用クローラーではなく、既存のGoogleクローラーが取得したコンテンツの利用可否を制御するトークンです。
| サービス | 検索・引用用 | ユーザー操作による取得 | 学習用 |
|---|---|---|---|
| OpenAI(ChatGPT) | OAI-SearchBot | ChatGPT-User | GPTBot |
| Perplexity | PerplexityBot | Perplexity-User | (PerplexityBotは基盤モデルの学習に使われないと明記) |
| Google(Google検索/Gemini) | Googlebot(Google検索) | ― | Google-Extended(Geminiの学習に加え、一部のグラウンディングも制御。クロールは既存のGoogleクローラーが行う) |
各社の公式ドキュメントから読み取れるポイントは次のとおりです。
- OAI-SearchBotは、ChatGPTの検索掲載のための主要なアクセス管理対象です。 OpenAIは、検索のオプトアウトはOAI-SearchBotで管理するよう案内しており、ChatGPT-Userは検索への表示を決めるものではないとしています。また、robots.txtの設定はクローラーごとに独立しているため、GPTBotの拒否だけを理由にChatGPTの検索掲載から除外されるわけではありません。
- ユーザー操作による取得は、robots.txtに従わない場合があります。 OpenAIはChatGPT-Userについて、PerplexityはPerplexity-Userについて、ユーザーの依頼による取得であるためrobots.txtのルールが適用されない場合があると説明しています。
- Google-ExtendedはGoogle検索には影響しませんが、Geminiには影響します。 Googleは、Google-ExtendedがGoogle検索への掲載にも順位にも影響しないと明記しています。一方で、Google-ExtendedはGeminiモデルの学習に加え、GeminiアプリやVertex AIの「Grounding with Google Search」でのグラウンディング(回答生成時に検索インデックスの情報を参照させること)も対象です。CloudflareのDisallow AI Trainingは、robots.txtでGoogle-Extendedを拒否する記述を追加します。「学習を拒否してもAI検索には一切影響しない」とは言い切れません。
このため、Agentを遮断した場合の影響は「AI経由の流入をすべて失う」ではなく、「ユーザー操作による取得など、一部の経路や利用体験を制限する可能性がある」と捉えるのが正確です。また、学習を許可しても、学習データとして採用されることや、AIの回答で推薦されることが保証されるわけではありません。
robots.txtでの意思表示と、Cloudflareでの遮断は何が違うのか?
robots.txtは「クロールしてほしくない」という意思表示であり、Cloudflareによる遮断はネットワーク上で実際にアクセスを止める仕組みです。Cloudflareは、robots.txtだけでは不十分だと説明しています。robots.txtは誰がなぜクロールしているかを検証できず、従わないクローラーを止めることもできないためです。
Disallow AI Trainingは、Bot Preference Syncを通じてrobots.txtに学習拒否の意思を公開し、対象の混合用途クローラーによる検索向けクロールを維持する設定です。一方で、学習専用クローラーなどへのアクセスは遮断します。Blockは混合用途クローラーも含めて遮断するため、検索向けクロールにも影響します。
サイトの種類ごとに、どの設定を選ぶべきか?
最適な設定は、サイトの収益モデルやコンテンツ利用方針を踏まえて判断します。原文のサイト種別ごとの方針を、2026年9月15日以降の選択肢に合わせて整理すると次のとおりです。
| サイトの種類 | 事業目標 | Search | Agent | Training | 考え方 |
|---|---|---|---|---|---|
| ブランド公式サイト/B2B | 権威性の確立とリード獲得 | Allow | Allow | AllowまたはDisallow AI Training | GEOが重要。AIエージェントは顧客がブランドを知る新しい経路になっている。学習利用は自社方針で選び、検索向けクロールに影響するBlockは避ける |
| EC | 商品露出とコンバージョン | Allow | Allow | AllowまたはDisallow AI Training | ユーザーはAIで比較・推薦を受ける行動を強めている。Agentの許可は、AI経由で商品情報に触れる経路を確保する |
| ニュース/広告収益型メディア | クリック数と広告収益 | Allow | Block on pages with ads | Disallow AI Training | AIの要約で広告閲覧のクリックが減るため、収益保護を優先する。Cloudflareの広告収益型向け推奨値と同じ。AIベンダーとのコンテンツライセンス交渉も選択肢 |
IT部門とマーケティング部門は何から始めるべきか?
最大のリスクは、マーケティング部門とIT部門の認識のずれです。IT部門が意図しない設定のままにしていると、マーケティング部門のGEO施策が想定どおりの成果を出せません。確認は次の5ステップで進めます。
- 利用状況の棚卸し:自社サイトがCloudflareを利用しているかを、IT部門または制作会社に確認する。
- 目標のすり合わせ:マーケティング/GEO担当とIT部門で、優先するのが流入、コンバージョン、広告収益の保護のどれかを合意する。
- 移行後の設定を確認する:管理画面で、Search・Agent・Trainingの現在の設定を確認する。以前Blockを選んでいた場合は、Disallow AI Trainingに変わっていないかを確認する。
- Trainingの選択肢を選び分け、Bot Preference Syncを確認する:学習拒否を伝えたいならDisallow AI Training、検索向けクロールを含めて遮断したいならBlockを選ぶ。Disallow AI Trainingを使う場合は、Bot Preference Syncが有効になっているかを確認する。
- AI検索側のクローラーも確認する:robots.txtで、OAI-SearchBot、PerplexityBot、Google-Extendedなどの扱いが自社の方針と一致しているかを確認する。
よくある質問(FAQ)
Q1. CloudflareのAIクローラー3区分(Search/Agent/Training)とは何ですか?
A. Searchは検索インデックスを構築してクリックにつなげるクローラーで、GooglebotやBingbotが該当します。Agentはユーザーの代わりにリアルタイムで情報を取得し、回答の要約やタスクを実行するクローラーです。TrainingはLLMの学習データを一括収集するクローラーで、BytespiderやCCBotが該当します。
Q2. AI学習を拒否すると、Google検索の露出も失いますか?
A. CloudflareのTraining設定で「Disallow AI Training」を選べば、Googlebotなど条件を満たす混合用途クローラーに学習拒否を通知しつつ、検索向けクロールを維持できます。Trainingを「Block」にすると、混合用途クローラーもサイト全体で遮断され、検索向けクロールに影響します。「Block on pages with ads」にした場合は、広告掲載ページで同じ影響が出ます。なお、Disallow AI TrainingからBingへ学習拒否を自動通知する仕組みは未対応で、Microsoftは2027年初めの対応を目標としています。それまではNOARCHIVEメタタグなどを別途検討してください。
Q3. 学習を拒否すると、GeminiやChatGPTの回答にも影響しますか?
A. サービスによって異なります。OpenAIは学習用のGPTBotと検索用のOAI-SearchBotを分けており、GPTBotの拒否だけを理由にChatGPTの検索掲載から除外されるわけではありません。GoogleのGoogle-ExtendedはGoogle検索には影響しませんが、Geminiの学習に加えてGeminiアプリなどの一部のグラウンディング用途も対象になります。
Q4. 広告収益型メディアやニュースサイトもAIクローラーを全開放すべきですか?
A. 広告収益型メディアは全開放が最適とは限りません。AIの回答内で用件が完結するゼロクリックにより、広告収益が減る可能性があるためです。Cloudflareは広告収益型サイト向けに、Search=Allow、Training=Disallow AI Training、Agent=Block on pages with adsを推奨値としています。AIベンダーとの有償コンテンツライセンス交渉も選択肢です。
Q5. 既存サイトは何か対応が必要ですか?
A. Cloudflareは、多くのユーザーは対応不要としています。既存サイトの設定は以前の状態に応じて移行され、TrainingのBlockはDisallow AI Trainingに変換されています。検索向けクロールを含めて遮断したい場合はBlockを選び直す必要があるため、IT部門と現在の設定を確認してください。